히카루의 바둑 2 한글패치 제작기 — 화면에 그려지는 글자부터 메뉴 그림까지
코나미의 게임보이 어드밴스용 히카루의 바둑 2 일본판에 스토리 대사와 시스템 화면의 한글을 넣었습니다. 화면에 보이는 글자가 어디서 왔는지부터 확인해야 했습니다. 대사창은 같은 위치를 쓰는데 내용만 바뀌었고, 메뉴 글자는 대사와 다른 방식으로 저장되어 있었습니다. 이 글은 실제 제작 중에 확인한 위치와 화면을 바탕으로, 대사·글꼴·그림을 각각 어떻게 처리했는지 기록한 제작기입니다.
- 어떤 판본을 대상으로 했나
- 대사가 화면으로 가는 경로
- 서로 다른 크기의 세 벌 글꼴
- 메뉴와 이름 입력 화면의 글자는 그림이다
- 잘못 짚은 글리프 위치와 빠진 문장 앞부분
- 화면과 데이터로 확인한 것, 남겨 둔 것
- 패치 적용과 배포 원칙
1. 어떤 판본을 대상으로 했나
대상은 Hikaru no Go 2 (Japan)입니다. 게임 헤더에는 HIKARUNOGO2, 게임코드에는 AKEJ가 적혀 있습니다. 원본 크기는 16,777,216바이트이고 CRC32는 04129a22, SHA-256은 33f2160de8880d2f47f1a34ee7bc5f6fd288ddda376904217a3d40c0e3b82f50입니다. 같은 제목이라도 다른 판본에 바이트 위치를 그대로 적용할 수 없으므로, 패치 적용 전에 원본 파일의 해시를 대조해야 합니다. 이 해시들은 게임이나 원본 파일을 배포하기 위한 값이 아니라 적용 대상을 식별하기 위한 값입니다.
공개된 한글패치 버전은 v1.0이며 배포 기록상 발행일은 2026년 7월 9일입니다. 이 판에는 스토리 대사와 시스템 UI 한글화, 메뉴 정렬과 소형 글꼴의 가독성 수정, 경어 표현 및 응답 표현의 정정이 반영되어 있습니다. 아래의 개발 기록에는 초기 조사에서 세운 가설과 뒤에 화면으로 바로잡은 판단이 함께 남아 있습니다. 서로 모순되는 기록은 최종 실측 결과를 기준으로 설명합니다.
2. 대사가 화면으로 가는 경로
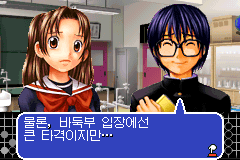
처음 일본어 문자열을 전체에서 찾았을 때 얻은 결과는 실행 코드까지 문자로 오인한 잡음이었습니다. 그때는 압축된 문자열일 가능성도 검토했습니다. 그러나 첫 대사 화면과 다음 대사 화면의 작업 메모리 덤프를 비교하면서 이 가설은 바뀌었습니다. 화면의 바둑부 대사가 바뀌어도 글자 배치용 타일맵은 바뀌지 않았고, 글자 그림을 담는 비디오 메모리 영역은 대량으로 바뀌었습니다. 타일은 화면을 작은 칸으로 나눠 그리는 그림 단위이고, 타일맵은 어느 칸에 어떤 타일을 놓을지 가리키는 표입니다. 이 게임은 대사가 바뀔 때 타일 번호표를 교체하는 대신 글자의 그림 자체를 다시 그렸습니다.
작업 메모리에는 비디오 메모리의 글자 그림과 같은 내용도 보였습니다. 글자를 먼저 작업 메모리에 그린 뒤 화면용 메모리로 복사하는 경로를 확인한 것입니다. 이어서 작업 메모리에서 일본어 대사를 참조하는 주소를 찾았습니다. 스크립트 읽기 위치가 0x08702E44에서 0x08702E5C로 0x18바이트 전진하는 동안, 8바이트짜리 명령 레코드 세 개가 지나갔습니다. 그 가운데 명령값 0x54의 주소가 대사 문자열을 가리켰습니다. 포인터란 이렇게 실제 글자가 있는 곳의 주소를 담아 두는 값입니다.
실제 글자는 Shift-JIS 평문이었습니다. Shift-JIS는 일본어 문자를 바이트로 저장하는 인코딩 방식입니다. 예를 들어 원본 파일 오프셋 0x7022B2에서 화면에 표시된 대사를 찾았고, 문자열의 끝은 값 0x00으로 표시되어 있었습니다. 줄을 바꾸는 표지도 문자열 안에 들어 있었습니다. 처음의 “압축 때문에 문자열을 못 찾는다”는 판단은 틀렸습니다. 화면의 글자 그림이 실시간으로 만들어진다는 사실과, 글자의 원본 문자열이 평문이라는 사실은 서로 다른 이야기입니다.
수정 가능한 문자열은 파일 오프셋 0x700000부터 0x7DB680 사이에 분포했고, 조사 기록에는 약 434개의 연속 블록이 표시되어 있습니다. 번역문을 넣을 때는 원문의 종료 바이트와 바로 뒤 데이터의 경계를 지켜야 했습니다. 일본어 한 글자와 한글 한 글자가 언제나 같은 저장 공간을 차지한다고 가정하지 않고, 문자열마다 사용할 수 있는 바이트 예산을 확인했습니다. 원문보다 긴 문장을 단순히 뒤로 밀어 쓰면 다음 문자열 또는 명령의 주소가 가리키는 데이터까지 바뀔 수 있기 때문입니다.
3. 서로 다른 크기의 세 벌 글꼴
문자 코드가 곧바로 화면의 픽셀이 되는 것도 아니었습니다. 파일 오프셋 0x688A44에 있는 표가 Shift-JIS 코드와 글리프 번호를 연결합니다. 글리프는 화면에 실제로 그리는 한 글자의 그림입니다. 이 표는 1,225개의 항목을 갖고 있고, 글꼴 세 벌이 같은 번호표를 공유합니다. 크기만 다른 글꼴이 따로 저장되어 있어 큰 대사 글꼴만 바꾸면 작은 글꼴에는 일본어 원본 그림이 남습니다.
| 글꼴 | 글리프 크기 | 글리프당 바이트 | 파일 시작 오프셋 |
|---|---|---|---|
| font0 | 8×8픽셀 | 32 | 0x7DB690 |
| font1 | 10×10픽셀 | 50 | 0x7E4FB0 |
| font2 | 12×12픽셀 | 72 | 0x7F3EF4 |
세 글꼴은 모두 4bpp로 기록되어 있습니다. 4bpp란 한 픽셀의 색 번호를 네 비트로 저장하는 방식입니다. 각 벌에는 1,225개의 글리프가 들어 있으며, 표에서 찾은 번호에 글리프당 바이트 수를 곱해 각 글자의 위치를 계산합니다. 큰 글꼴의 한글만 주입한 상태에서는 동일한 코드가 작은 글꼴에서 원래 한자를 가리키는 문제가 확인되었습니다. 예를 들어 한글 ‘코’에 대응하는 코드가 소형 글꼴에서는 원래의 한자 ‘服’ 그림으로 남아 있었습니다.
그래서 큰 글꼴의 12×12 한글 그림을 각각 8×8과 10×10으로 줄여, 같은 글리프 번호의 작은 글꼴 두 벌에도 기록했습니다. 제작 기록에는 당시 사용한 한글 856음절을 두 작은 글꼴에 각각 반영하고 정적 렌더링으로 대조했다고 적혀 있습니다. 여기서 정적 렌더링은 저장된 그림 데이터를 따로 읽어 그려 보는 검사입니다. 그 기록은 실제 게임의 모든 작은 글자 표시 상황을 화면에서 확인했다는 뜻은 아닙니다. 특히 8×8 크기의 한글은 획이 조밀하다는 한계가 남아 있습니다.
4. 메뉴와 이름 입력 화면의 글자는 그림이다
대사와 달리 메인 메뉴의 ‘캠페인’ 같은 라벨은 완성된 그림으로 저장되어 있었습니다. 화면에서 작은 그림 조각을 움직이는 OBJ 스프라이트와 배경 칸을 이어 놓는 BG 레이어를 따로 살폈습니다. 메인 메뉴 네 라벨의 그림은 화면에서는 왼쪽부터 읽지만 파일에는 오른쪽·가운데·왼쪽 스프라이트 순으로 놓여 있었습니다. 캠페인 및 프리 대국의 하위 메뉴에서도 버튼 글자는 OBJ, 헤더와 배너는 BG 쪽에 있었습니다. 단순히 글자를 왼쪽부터 파일에 이어 쓰면 원래 화면 배치와 맞지 않았습니다.
작업 기록상 메인 메뉴 네 라벨, 하위 메뉴 라벨 열 종, 이름 입력 화면의 탭 버튼 세 종을 포함해 사전에 그려진 그래픽 블록 17개를 위치 확인·재작화·화면 확인했습니다. 예를 들어 메인 메뉴 ‘캠페인’ 라벨의 시작 오프셋은 0xF71B80이고, 캠페인 시작 뒤 나오는 장소명 ‘葉瀬中 理科室’의 그림은 0x991D78에 있었습니다. 장소명은 ‘하제중 이과실’로 바꾸었습니다. 그림을 다시 그릴 때에는 원본 팔레트를 사용하고 원본과 같은 바이트 수의 자리만 교체했습니다. 파일 안의 다음 데이터를 밀어 내지 않기 위한 선택입니다.
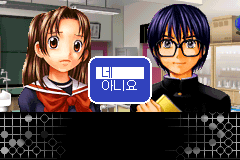
이름 입력 화면은 또 다른 형태였습니다. 겉보기에는 8bpp, 곧 픽셀당 여덟 비트의 색 번호를 쓰는 화면이지만, 저장된 그림에는 팔레트 번호의 아래쪽 네 비트만 있었습니다. 위쪽 비트는 게임이 화면에 올릴 때 덧붙였습니다. 처음에 8bpp 그림을 파일에서 그대로 찾지 못한 이유입니다. 아래쪽 비트만 비교한 뒤에야 그림의 위치를 찾았습니다. 이름 입력 탭 버튼 세 종은 바꾸었지만, 히라가나와 카타카나 문자표를 목표한 한글 97음절 배열로 완성하지는 못했습니다. 두 문자표의 그림 위치까지는 확인했으나, 원래의 칸마다 폭이 달라 화면 타일맵의 새 배치까지 필요했습니다. 확인되지 않은 타일맵 위치를 추측해 덮어쓰지 않았습니다.
5. 잘못 짚은 글리프 위치와 빠진 문장 앞부분
큰 글꼴의 처음 분석값은 0x7F003C였습니다. 그 주소를 기준으로 글리프를 넣었을 때 화면에는 의도한 한글 대신 다른 글자가 나왔습니다. 실제 화면과 대조한 결과, 처음 잡은 위치와 화면에 쓰이는 위치 사이에 글리프 223개만큼 차이가 있었습니다. 처음에는 게임이 글리프 번호에 223을 더해 그린다고 설명했습니다. 이후 작은 글꼴까지 포함해 글꼴 자료의 시작 주소를 다시 해석하자, 처음 주소가 다른 글꼴의 내부를 가리킨 것이 원인이었습니다. 올바른 큰 글꼴 시작 위치는 0x7F3EF4이며, 실제 주소 공식에는 별도의 223 더하기가 없습니다. 실측에서 본 차이를 곧바로 엔진의 규칙으로 단정했던 설명을 바로잡은 사례입니다.
문장 추출에도 별도 문제가 있었습니다. 등장인물 이름을 넣는 제어 토큰은 보통 글자와 달리 그 자리에서 치환되는 특수 바이트입니다. 초기 추출 과정에서 이 토큰을 문장 경계처럼 처리해, 토큰 앞에 이어져야 할 일본어 문장 앞부분이 빠진 항목이 남았습니다. 원본과 수정본의 해당 바이트를 대조한 누락 목록에는 “あ、①②”, “そういえば、三谷くんも↓①②” 같은 앞부분이 적혀 있습니다. 이 부분을 별도로 번역해 남겨 둔 바이트 구간에 다시 넣고, 이름 토큰 자리 자체는 유지하도록 했습니다.
한 차례 더 살펴보니 번역문과 이름 토큰 사이에 남는 공백을 채우면서 이름 바로 앞에 불규칙한 간격이 생길 수 있었습니다. 이미 들어간 문장을 다시 번역하지 않고, 그 공백을 같은 구간의 앞쪽으로 옮기는 수정 기록이 남아 있습니다. 또 두 바이트 문자 중 첫 바이트만 남으면 뒤따르는 이름 토큰 바이트와 잘못 묶여 토큰이 사라질 수 있었습니다. 남은 첫 바이트를 정리하고 토큰 순서를 원본과 비교하는 검사도 거쳤습니다. 단순히 화면에 한글이 나온다는 사실만으로 문장 전체와 이름 치환이 보존되었다고 할 수 없었습니다.
6. 화면과 데이터로 확인한 것, 남겨 둔 것
검증은 화면과 저장 데이터 양쪽에서 했습니다. 대사 전후의 작업 메모리와 비디오 메모리를 비교해 글자 그림이 갱신되는 영역을 찾았고, 원문 대사의 실제 주소를 명령 레코드의 포인터와 대조했습니다. 글꼴에서는 코드→글리프 번호표와 그림 크기를 맞춰 보고, 한글 주입 후 저장된 그림을 다시 렌더링했습니다. 메뉴는 배경과 스프라이트 레이어를 구분해 원본 그림을 찾고, 재작화 뒤 게임 화면에서 라벨과 장소명을 확인했습니다. 특히 글꼴의 223칸 차이처럼 정적 주소 계산과 화면 결과가 어긋나면 화면에서 확인한 쪽을 따라 원인을 다시 조사했습니다.
확인 범위도 구분해야 합니다. 작은 글꼴 두 벌의 데이터는 기록상 정적 그림 검증까지 마쳤지만, 모든 게임 장면에서 실제로 읽히는지는 같은 기록에서 미확인으로 남아 있습니다. 이름 입력 문자표의 한글 97음절 재배치 역시 완료된 항목이 아닙니다. 공개판의 스크린샷은 타이틀·대사·선택지의 상태를 보여 주지만, 그것만으로 게임의 모든 분기와 모든 문장이 검수되었다고 주장하지 않습니다. 제작 과정에서 한 번의 문자열 검색이나 한 장의 화면으로 판단했다면, 평문 대사를 압축 데이터로 오인하고 작은 글꼴과 이름 토큰의 문제도 놓쳤을 것입니다.
7. 패치 적용과 배포 원칙
배포 파일은 BPS 패치입니다. BPS는 원본 게임 파일과의 차이만 담는 패치 형식이며, 게임 파일 자체가 아닙니다. 운영자의 한글패치 배포 사이트에서 히카루의 바둑 2 v1.0 패치를 받아, 사용자가 정품에서 직접 만든 위 해시의 일본판 원본에 BPS 적용 프로그램으로 적용합니다. 원본 CRC32 04129a22와 SHA-256을 먼저 확인해야 합니다. 다른 판본이나 이미 수정된 파일에 적용하면 결과를 보장할 수 없습니다.
게임의 개발사는 Konami이며 원작의 게임 데이터와 저작권은 해당 권리자에게 있습니다. 여기에서는 ROM·BIOS·게임 데이터를 제공하거나 입수 경로를 안내하지 않습니다. 배포하는 것은 자체 제작한 한글화 차이 파일이며, 이 글에 적은 주소와 제작 과정은 해당 일본판에 대한 작업 기록입니다.